Штучний інтелект допомагає відкривати нові таємниці середньовічних архівів
Штучний інтелект поступово змінює підходи до вивчення історії, відкриваючи дослідникам нові можливості для роботи з величезними масивами середньовічних рукописів, документів та архівних матеріалів. Технології машинного навчання, автоматичного розпізнавання рукописного тексту та аналізу великих даних можуть допомогти опрацювати джерела, які раніше вимагали надзвичайно багато часу або взагалі залишалися практично недоступними для систематичного дослідження.
Однією з важливих подій у цьому напрямі стала міжнародна зустріч дослідників у Відні, де понад сто фахівців обговорили перспективи використання штучного інтелекту в історичних дослідженнях. Конференція відбулася 7–9 вересня 2026 року в Університеті Відня в межах другого міжнародного обміну мережі SCOOP — Source Codes of the Past.
Організаторами заходу виступили Інститут досліджень Середньовіччя Австрійської академії наук та факультет історичних і культурологічних досліджень Університету Відня. У роботі зустрічі взяли участь історики, філологи, палеографи, архівісти, бібліотекарі, комп’ютерні науковці, спеціалісти з машинного навчання та розробники програмного забезпечення.
Чому середньовічні архіви складно досліджувати
У бібліотеках та архівах у різних країнах світу зберігаються величезні масиви історичних джерел. Серед них — рукописи, папіруси, документи, літописні матеріали та інші тексти, які можуть містити важливу інформацію про політичне, соціальне, економічне й культурне життя минулих епох.
Однак значна частина таких джерел досі не була повністю опрацьована.
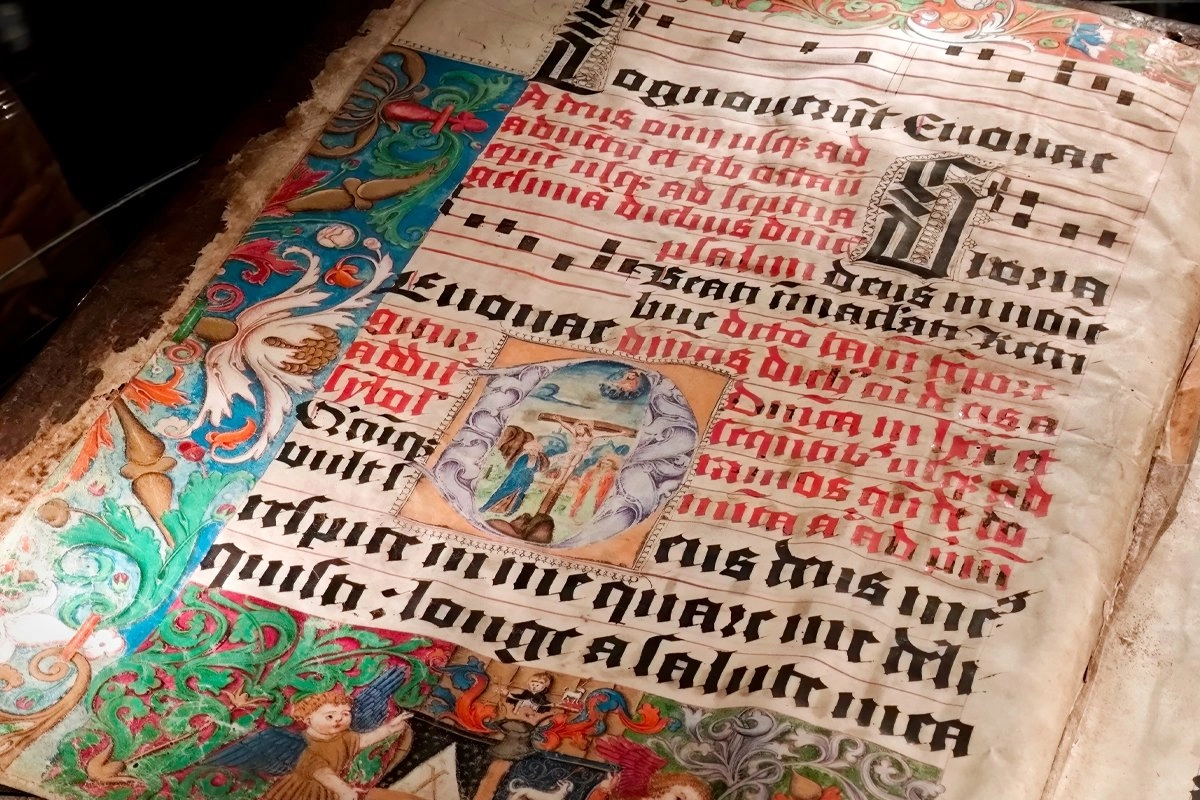
Однією з причин є складність роботи з рукописними текстами. Середньовічні документи могли створюватися різними писарями, використовувати відмінні стилі письма, мови та системи написання. До цього додаються пошкодження паперу або пергаменту, вицвілі чорнила, відсутні фрагменти тексту та інші фізичні дефекти.
Для історика або палеографа прочитання й транскрибування такого документа може бути тривалим процесом. Якщо ж ідеться про тисячі або десятки тисяч сторінок, традиційні методи дослідження суттєво обмежують швидкість роботи.
Саме цю проблему намагаються вирішити сучасні цифрові технології.
Як штучний інтелект допомагає читати стародавні рукописи
Одним із ключових напрямів є автоматичне розпізнавання рукописного тексту — HTR, або Handwritten Text Recognition. Його завдання полягає у використанні алгоритмів для розпізнавання написаних від руки текстів та перетворення їх на цифровий формат, придатний для подальшого пошуку й аналізу.
Мережа SCOOP спеціалізується саме на автоматичній транскрипції та аналізі рукописних історичних джерел. Вона об’єднує представників гуманітарних і технічних дисциплін, щоб поєднати знання про історичні документи з можливостями сучасного машинного навчання.
Це особливо важливо для середньовічних джерел, де автоматичне розпізнавання повинно враховувати не лише сам текст, а й особливості почерку, мови, шрифту, структури документа та стану матеріалу.
У результаті дослідники можуть отримати цифрову транскрипцію, яку надалі можна шукати, порівнювати та аналізувати за допомогою комп’ютерних інструментів.
Від окремого документа до аналізу величезних колекцій
Використання штучного інтелекту може змінити не лише швидкість роботи істориків, а й масштаб самого дослідження.
Традиційний підхід передбачає детальне вивчення окремих документів або невеликих груп джерел. Цифрові технології дозволяють перейти до аналізу значно більших масивів інформації.
Після оцифрування та транскрибування великої кількості документів алгоритми можуть допомагати дослідникам знаходити повторювані імена, географічні назви, мовні особливості, тематичні зв’язки та інші закономірності.
Наприклад, якщо певне ім’я згадується у сотнях документів, комп’ютерні методи можуть допомогти швидко виявити всі відповідні згадки. Аналогічний підхід можна застосовувати до назв населених пунктів, організацій, подій або інших історичних об’єктів.
Це створює можливість досліджувати не тільки окремі документи, а й взаємозв’язки між великими колекціями історичних джерел.
Мережа SCOOP об’єднує істориків і технологічних фахівців
SCOOP — Source Codes of the Past — є міжнародною мережею, створеною для розвитку автоматичного розпізнавання та аналізу історичних рукописних джерел.
Перша зустріч мережі відбулася в Принстоні у 2025 році. Друге засідання провели у Відні у вересні 2026 року. На ньому близько ста учасників працювали у форматі основних доповідей, тематичних робочих груп, круглих столів, демонстрацій та відкритих дискусій.
Особливістю SCOOP є міждисциплінарний характер. До мережі входять фахівці, які мають різний професійний досвід, але працюють над спільною проблемою — як за допомогою сучасних технологій зробити величезну спадщину рукописних джерел доступнішою для дослідження.
Учасники обговорюють розвиток моделей штучного інтелекту, технічну інфраструктуру, автоматичне розпізнавання рукописів, методи транскрипції та використання великих даних у гуманітарних дослідженнях.
До Відня повернувся історик із Принстона
Важливу роль у розвитку цього напряму відіграє медієвіст Гельмут Рейміц. Після 18 років роботи в Принстонському університеті він повернувся до Відня, де став професором Університету Відня та був призначений директором Інституту досліджень Середньовіччя Австрійської академії наук із початком роботи на цій посаді у січні 2027 року.
Саме з його поверненням пов’язують прагнення перетворити Відень на один із центральних майданчиків для розвитку мережі SCOOP та співпраці між істориками й фахівцями з цифрових технологій.
Рейміц спеціалізується, зокрема, на історії ранньосередньовічної Європи, питаннях ідентичності та різноманітності. Він здобув докторський ступінь у Віденському університеті, а з 2008 року працював у Принстоні, де у 2013 році став професором історичного факультету.
Повернення дослідника до Відня має не лише особисте чи академічне значення. Воно також демонструє прагнення австрійських наукових установ поєднати традиційні підходи до медієвістики з новими методами цифрових гуманітарних наук.
Штучний інтелект не замінює історика
Попри значний потенціал штучного інтелекту, його використання в роботі з історичними джерелами не означає автоматичної заміни фахівців.
Навпаки, дослідник залишається необхідним для перевірки отриманих результатів. Середньовічний текст може містити нестандартні скорочення, незвичні форми написання, пошкоджені фрагменти або слова, значення яких залежить від історичного контексту.
Тому автоматична транскрипція повинна розглядатися як інструмент, який допомагає фахівцеві працювати швидше, а не як безпомилковий механізм, здатний самостійно інтерпретувати історичні джерела.
Учасники зустрічі SCOOP окремо розглядають проблеми надійності автоматичних транскрипцій, технічну архітектуру систем та методологічні питання використання штучного інтелекту в історичних дослідженнях.
Нові можливості для цифрової історії
Поєднання штучного інтелекту, оцифрування архівів та методів аналізу великих даних може суттєво розширити можливості історичної науки.
Документи, які раніше потрібно було переглядати вручну, можуть ставати доступними для цифрового пошуку. Великі колекції можна буде аналізувати комплексно, виявляючи зв’язки, які складно помітити під час роботи з окремими джерелами.
Особливо перспективним це є для дослідження мов і писемностей, представлених меншою кількістю цифрових ресурсів. Фахівці вже працюють над адаптацією технологій автоматичного розпізнавання до різних мов, писемностей та рукописних традицій.
Австрійська академія наук також розвиває власні цифрові проєкти, пов’язані зі штучним інтелектом і візуалізацією даних. Її Digital Lab має на меті підтримувати цифрову гуманітаристику та координувати відповідні дослідницькі проєкти в Інституті досліджень Середньовіччя.
Штучний інтелект відкриває доступ до прихованої історії
Потенціал нових технологій полягає не лише у прискоренні вже відомих методів дослідження. Штучний інтелект може допомогти звернути увагу на джерела, які раніше залишалися поза межами систематичного наукового аналізу.
У світі досі зберігаються величезні масиви історичних матеріалів, які потребують прочитання, транскрибування, класифікації та порівняння. Їхнє опрацювання традиційними методами може тривати десятиліттями.
Автоматизовані технології потенційно дозволяють значно прискорити цей процес і водночас створити нові інструменти для пошуку історичних закономірностей.
Показовим є і ширший досвід Австрійської академії наук. У 2026 році її дослідники також розвивають проєкт Apollo — масштабну модель штучного інтелекту для давньогрецької мови, призначену для роботи з великими масивами античних текстів. Це демонструє, що застосування ШІ до історичних джерел поступово охоплює різні періоди, мови та типи документів.
Майбутнє дослідження середньовічних джерел
Розвиток штучного інтелекту може стати одним із ключових напрямів сучасної цифрової історії. Поєднання роботи істориків, архівістів, філологів, палеографів та спеціалістів із машинного навчання створює можливість по-новому працювати з величезними масивами документальної спадщини.
У перспективі такі технології можуть зробити значно більшу кількість середньовічних рукописів доступною для пошуку та наукового аналізу. Водночас їхнє використання потребуватиме ретельної перевірки результатів, якісних навчальних даних і збереження ролі професійної історичної інтерпретації.
Таким чином, штучний інтелект не просто допомагає швидше читати старі документи. Він поступово змінює масштаб, на якому може працювати історична наука, дозволяючи дослідникам переходити від вивчення окремих рукописів до комплексного аналізу великих архівних колекцій. Саме в цьому дослідники бачать одну з найважливіших перспектив цифрової гуманітаристики — можливість повернути до наукового обігу величезні обсяги знань, які століттями зберігалися в архівах.